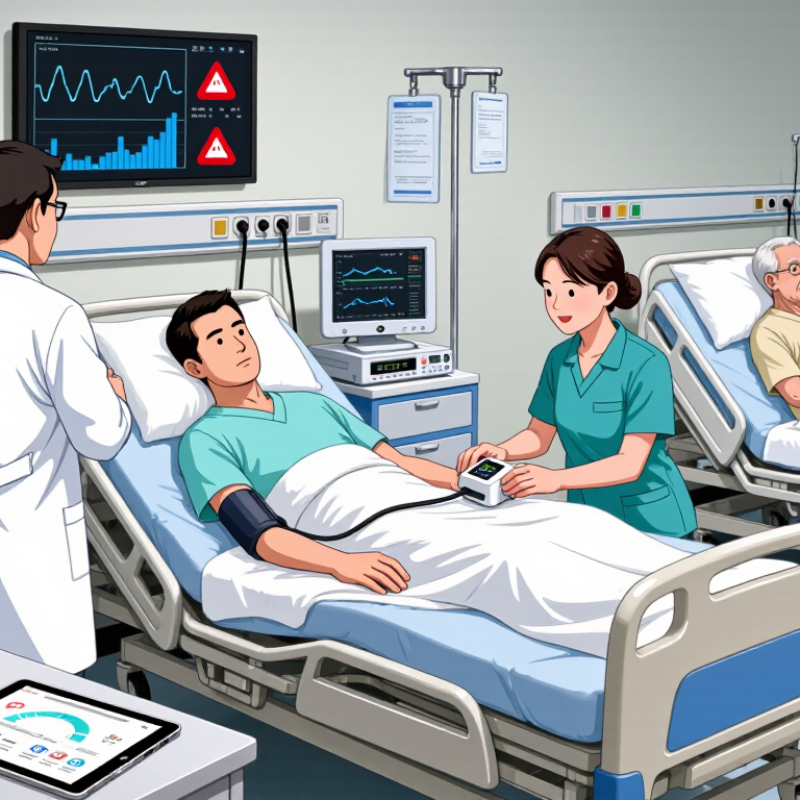
Avaliar uma solução de monitoramento exige mais do que observar números na tela. A pergunta central é: quais fatores afetam a precisão do monitoramento do paciente? A resposta envolve sensores, algoritmos, circunstâncias e contexto clínico.
Em um leito chinês, por exemplo, um oxímetro pode registrar valores instáveis com mãos frias, movimento ou baixa perfusão. Um manguito mal ajustado também distorce a pressão arterial. Pequenos erros de posicionamento alteram decisões importantes. E isso acontece.
A experiência da equipe influencia tanto quanto a tecnologia. Profissionais precisam considerar representantes, comparar tendências e confirmar sinais inesperados. Alarmes excessivos podem causar fadiga e atrasar uma resposta necessária. Barbara J. Drew, especialista em monitoramento psicológico, resume uma preocupação essencial: “A fadiga de alarmes é uma questão de segurança do paciente.”
A confiabilidade depende ainda da manutenção, da conectividade e da integração com o prontuário. Dados atrasados não representam obscuridade para o paciente. Sistemas modernos devem informar a qualidade do sinal, não apenas exibir uma leitura. Essa transparência fortalece a decisão clínica.
Também é necessário avaliar diferentes perfis de pacientes. Crianças, idosos, pessoas com pele escura ou alterações circulatórias podem apresentar desafios específicos. Evidências locais e validação independentes ajudam a reduzir o fluxo apressado. Nenhuma solução é perfeita.
Por isso, este conteúdo analisará fatores técnicos, humanos e ambientais. A proposta não é prometer precisão absoluta. É identificar limites, testar resultados e melhorar continuamente o monitoramento.
Definir o escopo é o ponto mais importante de uma solução de monitoramento. Lista de ativos críticos, dependências, responsáveis e cronogramas de operação. Servidores, bancos de dados, APIs e links de rede precisam de indicadores próprios. Monitorar tudo parece seguro, mas aumenta ruído e custos.
O KPI mínimo deve combinar disponibilidade, latência, erros e capacidade. Uma disponibilidade de 99,9% permite cerca de 8 horas e 46 minutos de indisponibilidade anual. Esse limite pode ser insuficiente para pagamentos, saúde ou operações contínuas. O Uptime Institute regista que falhas relevantes ainda geram custos superiores a 100 mil dólares em muitos incidentes analisados. O impacto financeiro cresce quando não existem alertas acionáveis.
Defina também a janela de medição e a fonte dos dados. Um painel pode mostrar 99,9%, enquanto os usuários enfrentam lentidão regional. Testes sintéticos, telemetria interna e registros de incidentes devem ser comparados. O relatório Cost of a Data Breach 2024, do IBM Institute for Business Value, aponta custo médio global de 4,88 milhões de dólares por incidente. Nem todo alerta merece escalada. Ainda assim, reduza alertas para melhorar o painel pode esconder sinais importantes. A revisão mensal dos KPIs deve questionar métricas antigas, limites artificiais e ativos esquecidos.
A definição do escopo deve abranger os ativos monitorados, os KPIs de serviço e uma meta de disponibilidade mínima de 99,9%.
O tempo máximo de inatividade é calculado para um mês de 30 dias: 99,9% permite 43,2 minutos, 99,95% permite 21,6 minutos e 99,99% permite 4,32 minutos. Os KPIs típicos incluem disponibilidade, tempo de resposta, taxa de erros e tempo de recuperação de alertas.
A escolha dos sensores define a qualidade de qualquer solução de monitoramento. Na prática de campo, a precisão não significa apenas o número listado na ficha técnica. É preciso avaliar faixa de medição, resolução, estabilidade e comportamento diante de variações de temperatura. Um sensor muito preciso, mas mal instalado, pode produzir dados pouco confiáveis.
A amostragem deve acompanhar a velocidade do interesse observado. A temperatura em uma câmara pode exigir intervalos maiores. Vibração ou pressão assustadora pede leituras muito mais rápidas. Mostrar lentamente ocultar picos importantes. Mostrar rápido demais aumenta o volume de dados e pode sobrecarregar a análise. Esse equilíbrio costuma exigir testes reais, não apenas cálculos teóricos.
A proteção IP65 resiste à poeira e jatos de água. A IP67 oferece proteção contra poeira e transferência temporária, conforme condições especificadas. Isso não torna o sensor indestrutível. Cabos, conectores e vedações também precisam ser selecionados. Em uma instalação anterior, a carcaça estava adequada, mas o conector acumulava umidade. O problema só apareceu após semanas. Por isso, confiável, inspeções periódicas e validação no local devem fazer parte do projeto. Ainda há margem para melhorar.
| Variável de monitoramento | Tipo de sensor recomendado | Precisão típica | Taxa de amostragem prática | Proteção Ambiental | Principais considerações de seleção |
|---|---|---|---|---|---|
| Temperatura | Detector de temperatura de resistência industrial, como um sensor da classe Pt100. | ±0,1 a ±0,3 °C | 1 amostra a cada 1–10 segundos para monitoramento geral do processo. | IP65 ou IP67 | Escolha um comprimento de sonda, tempo de resposta, tipo de cabo e método de instalação adequados. Para obter maior precisão, pode ser necessário calibrar e montar o equipamento de forma estável. |
| Temperatura em processos de rápida mudança | Termopar aterrado ou não aterrado | Normalmente, ±1,5 a ±2,5 °C | 10 a 100 amostras por segundo quando mudanças rápidas precisam ser capturadas. | IP65 ou IP67 no invólucro | Os termopares respondem rapidamente, mas a precisão depende do tipo de termopar, da compensação da junção fria, da fiação e do controle de ruído elétrico. |
| Umidade relativa | Sensor de umidade digital capacitivo | Aproximadamente ±2 a ±3% de umidade relativa. | 1 amostra a cada 5–60 segundos | IP65; IP67 somente com membrana adequada ou sonda protegida. | Proteja o elemento sensor contra condensação, poeira e vapores químicos. Uma caixa à prova d'água não torna automaticamente o elemento sensor adequado para imersão. |
| Pressão | Transmissor de pressão piezoresistivo ou de extensômetro | Normalmente, ±0,25 a ±0,5% da escala completa. | 1–20 amostras por segundo para a maioria dos sistemas industriais | Classificação IP65 ou IP67 para a caixa do transmissor | Defina cuidadosamente a faixa de pressão. Uma faixa estreita e corretamente selecionada geralmente proporciona uma resolução útil melhor do que uma faixa muito ampla. |
| Vibração | Acelerômetro industrial com condicionamento de sinal | A resposta em frequência e a sensibilidade são mais importantes do que um único valor de precisão. | 1–25,6 kHz, dependendo da faixa de frequência monitorada. | IP65 ou IP67 para instalações expostas | A frequência de amostragem deve ser pelo menos o dobro da frequência mais alta de interesse; sistemas práticos geralmente usam uma margem maior e filtros anti-aliasing. |
| Nível do líquido | Sensor de nível ultrassônico ou hidrostático | Aproximadamente ±0,25 a ±1% da faixa de medição | 1 amostra a cada 1–10 segundos | IP65 para áreas protegidas; IP67 para riscos de respingos ou imersão temporária. | Os sistemas ultrassônicos requerem um caminho acústico desimpedido, enquanto os sistemas hidrostáticos requerem compatibilidade com o líquido e proteção contra o acúmulo de sedimentos. |
| Qualidade do ar ou concentração de gases | Sensor eletroquímico, de fotoionização ou infravermelho não dispersivo | Geralmente, a variação é de ±2–5% da leitura, dependendo do gás e da faixa de medição. | 1 amostra a cada 1–60 segundos | Caixa IP65 ou IP67 com filtro de proteção permeável a gases | Verifique a sensibilidade cruzada, a vida útil do sensor, o intervalo de calibração, o tempo de aquecimento e se o filtro de proteção afeta o tempo de resposta. |
Em aplicações URLLC, a latência de até 1 ms exige frequência contínua e precisa. Esse número representa uma meta técnica, não uma garantia permanente. Distância até a estação, obstáculos físicos e congestionamento alteram o desempenho.
Um sensor pode enviar dados de um braço robótico em poucos milissegundos. Porém, uma troca de antena pode interromper esse fluxo por instantes. Jitter, perda de pacotes e variações de sinal também influenciam a resposta. Por isso, o monitoramento deve registrar latência média, p95, p99 e disponibilidade.
A análise precisa considerar o horário de maior tráfego, a movimentação dos equipamentos e a temperatura ambiente. Registros sincronizados ajudam a comparar o instante do comando com a coleta da resposta. Servidores de borda direcionados ao caminho dos dados, mas não eliminam falhas de rádio ou problemas no dispositivo.
Na prática, prometer 1 m sem explicar o método pode induzir decisões erradas. É necessário indicar o tamanho dos pacotes, a frequência dos testes e as condições da rede. Também convém repetir a avaliação em turnos diferentes. Uma medição isolada parece convincente, mas pode ocultar instabilidade. faltam, muitas vezes, testes durante manutenção ou mudanças operacionais.
Em uma solução de monitoramento industrial, a qualidade da decisão começa antes do alerta. Validar dados significa confirmar origem, horário, unidade, contexto e integridade. Na prática, uma leitura de pressão sem carimbo confiável pode gerar uma investigação desnecessária. A IEC 62443 ajuda a organizar controles de segurança, responsabilidades e proteção do ciclo de vida. Ela não substitui testes locais. Cada ambiente possui riscos próprios.
Dicas: compare eventos com fontes independentes. Verifique relógios, identificadores e mudanças de configuração. Registre quem alterou cada parâmetro. Use trilhas de auditoria protegidas contra alterações simples. Teste também cenários de perda de comunicação. Pequenos desvios importantes.
A redução de falsos positivos depende de dados consistentes e regras ajustadas ao processo. Alarmes repetidos, sem contexto operacional, cansam as equipes e podem esconder ocorrências reais. Por isso, os especialistas devem verificar limites, frequência e prioridade dos alertas. Um painel confiável mostra evidências, não apenas a conclusão. Mesmo com controles maduros, os erros de sincronização podem permanecer. Esse ponto exige revisão contínua. Nem todo dado aparentemente normal é íntegro.
O que afeta uma solução de monitoramento aparece nos detalhes da operação. Em campo, sensores mal calibrados distorcem alarmes, tempos de parada e indicadores. Por isso, MTBF, MTTR e OEE excluem dados consistentes, históricos completos e critérios claros. Quando esses pontos estão alinhados, os resultados médios superiores a 85% tornam-se mais confiáveis. Não são garantidos.
O MTBF aumenta quando falhas repetitivas são investigadas, não apenas corrigidas. O MTTR diminui com diagnóstico remoto, peças disponíveis e procedimentos acessíveis. Já o OEE depende da disponibilidade, do desempenho e da qualidade registrados corretamente.
Em uma linha industrial, uma parada de oito minutos precisa ter causa, horário e impacto produtivo. Sem essa informação, o painel parece preciso, mas orienta decisões frágeis. Isso acontece.
A experiência dos técnicos também é importante. Eles transmitem vibrações, ruídos e aquecimento antes de muitos alertas automáticos. Integrar essa percepção ao monitoramento melhorado a análise. Ainda assim, as equipes podem classificar a mesma falha de maneiras diferentes.
Revisões periódicas ajudam a corrigir essa inconsistência. Indicadores acima de 85% devem ser auditados, comparados por período e relacionados às ordens de manutenção. O número isolado engana.
Liste servidores, bancos de dados, APIs, links de rede e dependências críticas. Indique responsáveis e horários de operação. Monitorar tudo pode aumentar custos e ruído.
Combine disponibilidade, latência, erros e capacidade. Cada ativo precisa de indicadores adequados ao seu funcionamento. Uma métrica isolada engana.
Esse índice permite cerca de 8 horas e 46 minutos de indisponibilidade anual. Pode ser insuficiente para pagamentos, saúde ou operações contínuas. O limite precisa refletir o impacto real.
Defina uma janela de medição clara e fontes confiáveis. Compare testes sintéticos, telemetria interna e registros de incidentes. Um painel pode mostrar 99,9%, enquanto usuários enfrentam lentidão.
Não. Priorize alertas conforme impacto, urgência e contexto operacional. Alertas repetidos cansam as equipes. Poucos alertas, porém. Reduzir demais pode esconder sinais importantes.
Confirme origem, horário, unidade, contexto e integridade. Verifique relógios, identificadores e alterações de configuração. Uma pressão sem horário confiável pode causar uma investigação desnecessária.
Ajuste limites, frequência e prioridade dos alertas. Compare eventos com fontes independentes. Registre quem alterou cada parâmetro. Ainda assim, alguns erros podem permanecer.
Teste esse cenário antes de depender dos alertas. Registre o momento da falha e seus efeitos. Verifique se o sistema diferencia silêncio de normalidade. Isso merece revisão contínua.
Revise os KPIs mensalmente. Questione métricas antigas, limites artificiais e ativos esquecidos. Analise mudanças de configuração e incidentes recentes. Nem todo dado normal está íntegro.
Uma solução eficaz de monitoramento começa pela definição clara do escopo, incluindo os ativos acompanhados, os indicadores-chave de desempenho e uma disponibilidade mínima de 99,9%. A escolha dos sensores deve considerar precisão, frequência de amostragem e resistência ambiental, com proteção IP65 ou IP67 quando necessário. Também é essencial avaliar a conectividade, especialmente em aplicações críticas que desativam baixa latência, como redes 5G com desempenho de até 1 ms em cenários URLLC.
A validação dos dados precisa garantir integridade, segurança e conformidade com a IEC 62443, além de reduzir falsos positivos que podem comprometer as decisões operacionais. Embora a expressão “que fatores afetam a precisão do monitoramento do paciente” esteja associada ao acompanhamento de pacientes, seus princípios de qualidade de dados também ajudam a estruturar sistemas confiáveis. Com esses cuidados, os resultados podem incluir melhoria do MTBF, redução do MTTR e OEE superior a 85%.
MediLink Saúde